四足歩行方策を、
別の物理エンジンで確かめる。
実機に載せる前に、もう一つのシミュレータで同じ方策を歩かせてみる。NVIDIA Isaac Lab(PhysX)で学習したUnitree Go2の歩行方策を、MuJoCo上でそのまま動かした記録です。
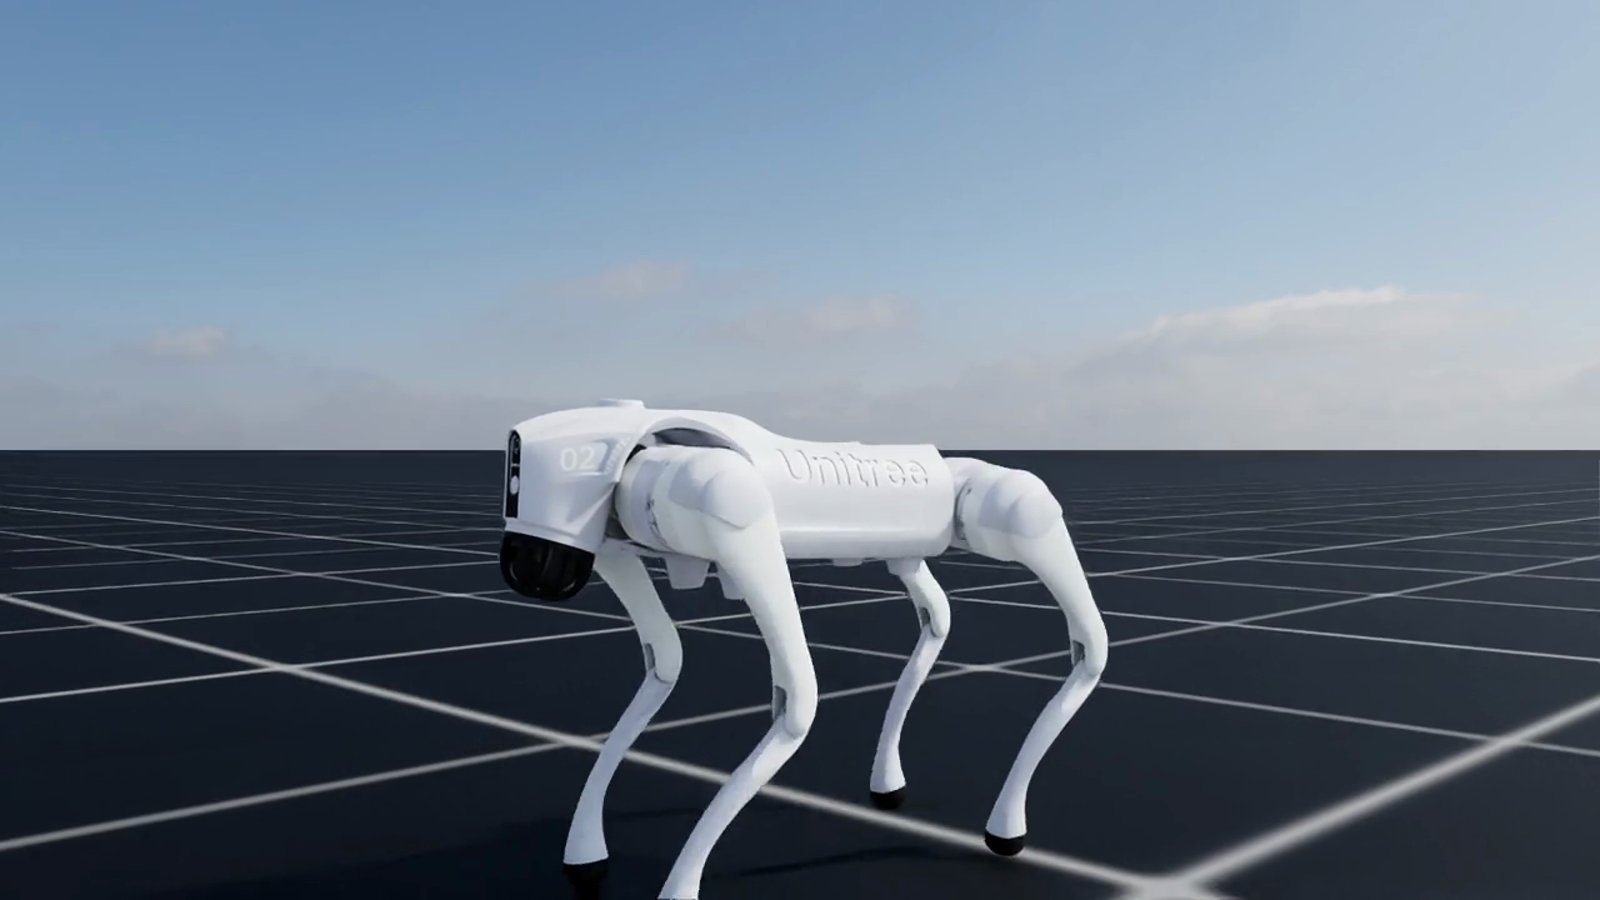
「シミュレータの癖」は、実機に持って行くまで見えない。
学習ログの報酬グラフだけでは、方策の限界か・エンジンの癖かを区別できない。
強化学習で四足歩行の方策を学習するとき、物理エンジンは一つに固定される。Isaac Labの場合はPhysXだ。
方策はその物理エンジンの数値的な挙動——接触処理の仕方、積分の刻み方、モーターモデルの近似——を暗黙のうちに学習に取り込む。エンジン固有の癖に適合しすぎていないか、それとも歩行として本質的に成立しているのか。学習ログの報酬グラフだけでは判別できない。
区別がつかないまま実機に持っていくと、実機で崩れたときに原因を切り分けられない。「方策の限界なのか」「PhysX特有の挙動に依存していただけなのか」「本当に実機特有の問題なのか」——三択のうち二つを先に消しておきたい。
しかし、比較対象を用意すること自体に手間がかかる。
別の物理エンジンで同じロボットを動かして比較する。言葉にすれば簡単だが、実施には以下の壁がある。
IsaacLab(PhysXバックエンド)は関節を種類ごとにまとめる。全4脚のhip関節、次に全4脚のthigh関節、次にcalf関節、という順序だ。一方MuJoCoのモデルファイル(MJCF)は脚ごとにまとめる。FL脚のhip/thigh/calf、次にFR脚、という順序になる。
この対応関係はどこにもドキュメント化されていない。実際に動かして確かめるしかない。
方策は学習時と同じ観測ベクトル(速度、姿勢、関節角度、直前の行動など)を同じ順序・同じスケールで受け取らなければ、正しく機能しない。ONNXに書き出された重みだけでは、この「入出力の約束事」は分からない。
IsaacLabからMuJoCoへ方策をそのまま持っていく標準経路はない。都度、自分で制御ループを組む必要がある。
公開モデルと、最小限の制御ループで橋を架ける。
MuJoCo公式の mujoco_menagerie が配布しているUnitree Go2モデル(unitree_go2/scene.xml)をそのまま採用した。関節構造・自由度はIsaacLab側のUNITREE_GO2_CFGと同じ実機Go2を再現している。
IsaacLab(RSL-RL)の学習済みチェックポイントをpolicy.onnxとしてエクスポート。推論エンジンに依存しない形にする。
物理シミュレーションのステップとPD制御ゲイン、そして方策が呼ばれる頻度を、学習時の設定に合わせる。
| 物理ステップ dt | 0.005 s |
|---|---|
| 制御decimation | 4(方策は50Hz) |
| PDゲイン | stiffness 25.0 / damping 0.5 |
| action_scale | 0.25 |
| 指令速度 | 前進 0.5 m/s(固定) |
観測は「線速度・角速度・重力方向・速度指令・関節角度(相対)・関節角速度・直前の行動」という学習時と同じ構成にし、推論時なのでノイズ項のみ外した。
実例として、直進歩行を検証した。
学習タスクはIsaac-Velocity-Flat-Unitree-Go2-v0。平坦地形での速度追従歩行方策(RSL-RL PPO、学習ステップ数 約3,800イテレーション)を、そのままMuJoCoの制御ループに接続した。
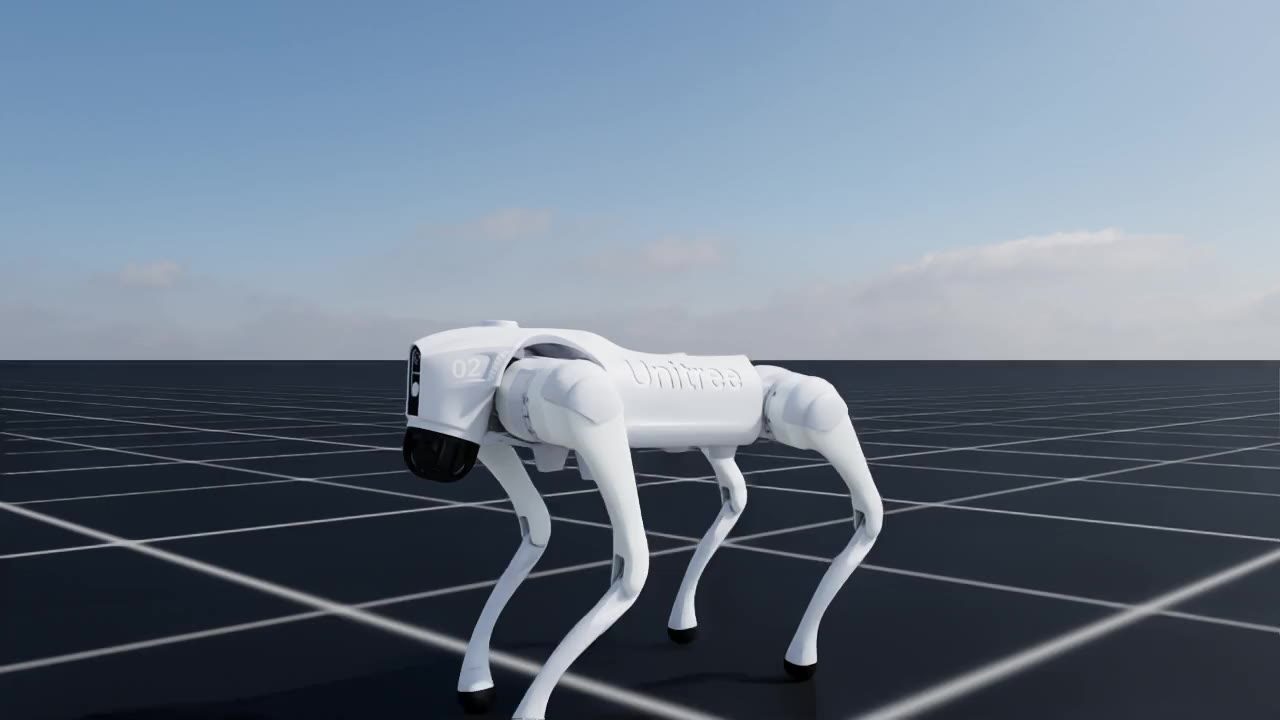
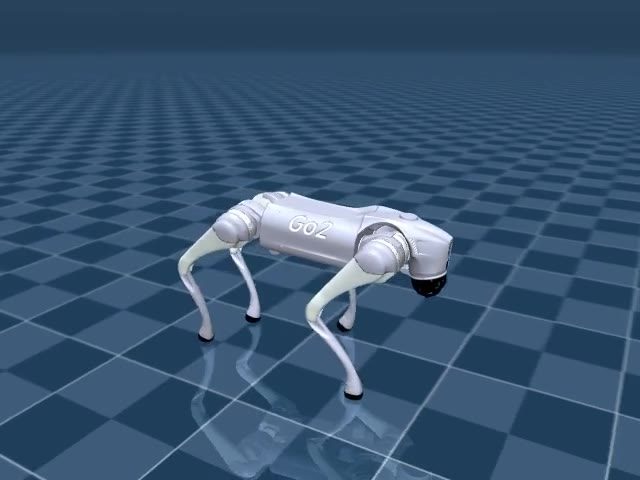
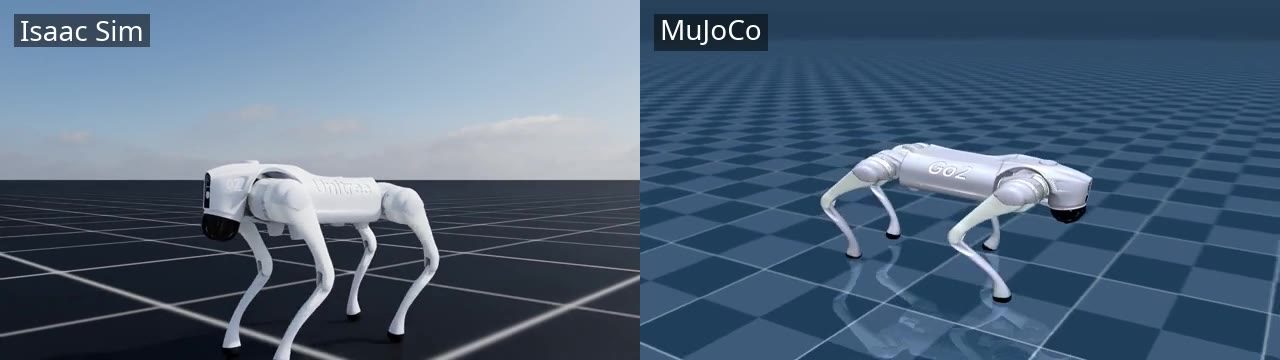
分かったのは、静止姿勢と歩行動作で「壊れ方」が違うということだった。
最初の試行は、歩き出してからバランスを崩した
関節配列を「脚ごとのまとめ」と仮定して組んだ最初のバージョンは、静止姿勢こそ正しく見えたが、歩行を始めた直後に姿勢が崩れ、数秒で停止した。
静止姿勢は関節名で個別に指定していたため問題が隠れ、歩行に入って初めて配列の対応ミスが表面化した形だ。
原因は、関節の並び順の規約の違いだった
IsaacLab(PhysXバックエンド)の関節順序は、scripts/sim2sim_transfer/config/newton_to_physx_go2.yamlの関節名リストで確認できる通り、種類ごとにまとめる並び(hip×4 → thigh×4 → calf×4)。対してMuJoCoのMJCFファイルは脚ごとにまとめる並び(FL全関節 → FR全関節 → …)。
同じ12次元の配列でも、何番目の数値がどの関節に対応するかが違う。これがaction配列に反映され、意図しない関節に指令が入っていた。
修正後は、安定して直進歩行した
| 修正前 | 修正後 | |
|---|---|---|
| 姿勢 | 歩行開始後に崩れ、停止 | 10秒間安定 |
| ロール角 | 大きく変動 | 約 -2°〜+1° |
| ピッチ角 | 大きく変動 | 約 -2°〜+6° |
| 前進距離(10秒) | ほぼ進まず停止 | 約4.35 m(理論値4.75 m) |
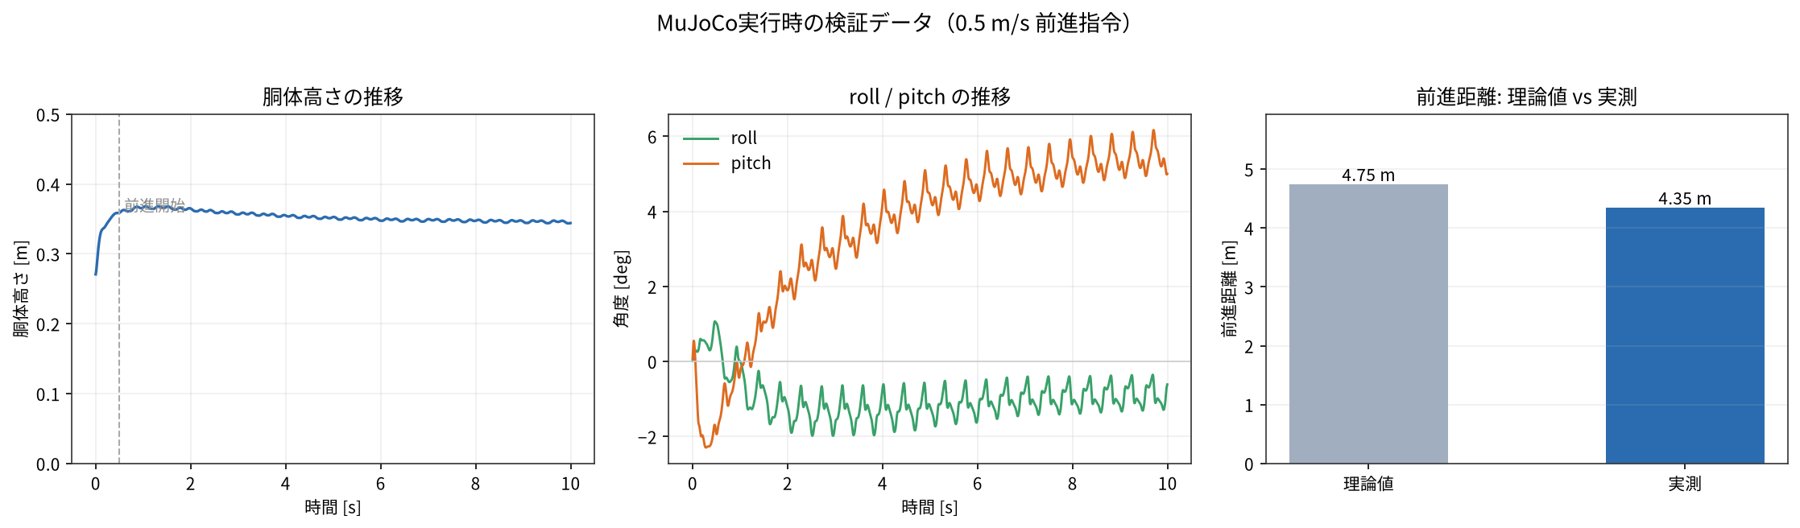
学習環境と別実装との突き合わせが、実装ミスを発見した
Isaac Lab単体の評価では、この配列対応ミスには気づけなかった。別の物理エンジン・別の実装で同じ方策を動かすという工程そのものが、バグ発見の手段として機能した。
sim-to-simで確かめられるのは、「エンジン間の挙動の一貫性」まで。
以上を踏まえ、sim-to-simは実機投入前のフィルタであって、最終確認ではないと位置づけて運用するのが妥当と考える。
何が言えるようになったか。
この方策は、少なくとも一つの物理エンジンの数値的な癖に依存した「見せかけの歩行」ではない。
この検証によって言えるのは次の一点である。独立に実装された別エンジン・別の関節規約の上でも、同じ重みで同じ歩行が再現された。
これは実機投入の前提条件であって、実機で歩ける保証そのものではない。ただし、この前提条件を確認せずに実機へ進むよりは、リスクを一段階減らせる。
次に確かめること。
使用環境。
- NVIDIA Isaac Lab v3.0.0-beta2(commit
414822f, 2026-09-10)/ PhysX - 学習アルゴリズム:RSL-RL PPO(タスク
Isaac-Velocity-Flat-Unitree-Go2-v0) - 物理ステップ dt = 0.005 s、制御decimation = 4(方策は50Hz)
- PDゲイン:stiffness 25.0 / damping 0.5(DCMotorCfg準拠、effort_limit 23.5 N·m)
- MuJoCo 3.14.0(Python bindings)
- mujoco_menagerie(commit
c96a32d, 2026-09-23)Unitree Go2モデル - ONNX Runtime 1.30.0(推論エンジン)
MuJoCo側の制御ループ実装(ONNXポリシー読み込み、関節順マッピング、PD制御、観測構築、追従カメラ)を参考コードとして公開します。
run_policy.py — MuJoCo制御ループの実装
import numpy as np
import mujoco
import onnxruntime as ort
import imageio

MODEL_XML = "mujoco_menagerie/unitree_go2/scene.xml"
POLICY_ONNX = "/home/ubuntu/isaacsim/IsaacLab/logs/rsl_rl/unitree_go2_flat/2026-09-11_23-24-25/exported/policy.onnx"

# Policy joint order: PhysX articulation order used by this training run (confirmed via
# scripts/sim2sim_transfer/config/newton_to_physx_go2.yaml target_joint_names, and env.yaml
# showing physics backend = isaaclab_physx.physics.physx_manager:PhysxManager).
# PhysX groups joints by TYPE (all hips, then all thighs, then all calves), each in FL,FR,RL,RR order.
POLICY_JOINT_ORDER = [
    "FL_hip_joint", "FR_hip_joint", "RL_hip_joint", "RR_hip_joint",
    "FL_thigh_joint", "FR_thigh_joint", "RL_thigh_joint", "RR_thigh_joint",
    "FL_calf_joint", "FR_calf_joint", "RL_calf_joint", "RR_calf_joint",
]
DEFAULT_JOINT_POS = {
    "FL_hip_joint": 0.1, "FR_hip_joint": -0.1, "RL_hip_joint": 0.1, "RR_hip_joint": -0.1,
    "FL_thigh_joint": 0.8, "FR_thigh_joint": 0.8, "RL_thigh_joint": 1.0, "RR_thigh_joint": 1.0,
    "FL_calf_joint": -1.5, "FR_calf_joint": -1.5, "RL_calf_joint": -1.5, "RR_calf_joint": -1.5,
}
ACTION_SCALE = 0.25
STIFFNESS = 25.0
DAMPING = 0.5
SIM_DT = 0.005
DECIMATION = 4
CONTROL_DT = SIM_DT * DECIMATION
SIM_DURATION = 10.0

CMD = np.array([0.5, 0.0, 0.0], dtype=np.float32)  # lin_vel_x, lin_vel_y, ang_vel_z

model = mujoco.MjModel.from_xml_path(MODEL_XML)
model.opt.timestep = SIM_DT
data = mujoco.MjData(model)

joint_qpos_adr = []
joint_qvel_adr = []
actuator_id = []
default_pos = np.zeros(12, dtype=np.float32)
for i, jn in enumerate(POLICY_JOINT_ORDER):
    jid = mujoco.mj_name2id(model, mujoco.mjtObj.mjOBJ_JOINT, jn)
    joint_qpos_adr.append(model.jnt_qposadr[jid])
    joint_qvel_adr.append(model.jnt_dofadr[jid])
    act_name = jn.replace("_joint", "")
    aid = mujoco.mj_name2id(model, mujoco.mjtObj.mjOBJ_ACTUATOR, act_name)
    actuator_id.append(aid)
    default_pos[i] = DEFAULT_JOINT_POS[jn]

joint_qpos_adr = np.array(joint_qpos_adr)
joint_qvel_adr = np.array(joint_qvel_adr)
actuator_id = np.array(actuator_id)

mujoco.mj_resetDataKeyframe(model, data, 0) if model.nkey > 0 else mujoco.mj_forward(model, data)
# set default joint pose explicitly (freejoint occupies qpos[0:7])
data.qpos[joint_qpos_adr] = default_pos
mujoco.mj_forward(model, data)

sess = ort.InferenceSession(POLICY_ONNX, providers=["CPUExecutionProvider"])
input_name = sess.get_inputs()[0].name
output_name = sess.get_outputs()[0].name

last_action = np.zeros(12, dtype=np.float32)
q_targets = default_pos.copy()

frames = []
renderer = mujoco.Renderer(model, height=480, width=640)
cam = mujoco.MjvCamera()
mujoco.mjv_defaultCamera(cam)
cam.distance = 1.5
cam.azimuth = 120
cam.elevation = -20
cam.trackbodyid = mujoco.mj_name2id(model, mujoco.mjtObj.mjOBJ_BODY, "base")
cam.type = mujoco.mjtCamera.mjCAMERA_TRACKING

n_steps = int(SIM_DURATION / SIM_DT)
control_every = DECIMATION
base_heights = []
rp_list = []
frame_stride = int((1 / 30) / SIM_DT)
SETTLE_STEPS = int(0.5 / CONTROL_DT)  # 0.5s standing before commanding velocity

for step in range(n_steps):
    if step % control_every == 0:
        qpos = data.qpos[joint_qpos_adr].astype(np.float32)
        qvel = data.qvel[joint_qvel_adr].astype(np.float32)
        joint_pos_rel = qpos - default_pos
        joint_vel_rel = qvel

        quat = data.qpos[3:7]  # w,x,y,z (mujoco convention)
        w, x, y, z = quat
        # gravity vector in body frame
        R = np.array([
            [1 - 2*(y*y+z*z), 2*(x*y - z*w), 2*(x*z + y*w)],
            [2*(x*y + z*w), 1 - 2*(x*x+z*z), 2*(y*z - x*w)],
            [2*(x*z - y*w), 2*(y*z + x*w), 1 - 2*(x*x+y*y)],
        ])
        gravity_world = np.array([0, 0, -1.0])
        projected_gravity = R.T @ gravity_world

        lin_vel_world = data.qvel[0:3]
        ang_vel_world = data.qvel[3:6]
        base_lin_vel = R.T @ lin_vel_world
        base_ang_vel = R.T @ ang_vel_world

        cmd_now = CMD if step >= SETTLE_STEPS else np.zeros(3, dtype=np.float32)
        obs = np.concatenate([
            base_lin_vel, base_ang_vel, projected_gravity, cmd_now,
            joint_pos_rel, joint_vel_rel, last_action,
        ]).astype(np.float32).reshape(1, -1)

        action = sess.run([output_name], {input_name: obs})[0].reshape(-1)
        last_action = action.copy()
        q_targets = default_pos + action * ACTION_SCALE

    q = data.qpos[joint_qpos_adr]
    dq = data.qvel[joint_qvel_adr]
    torque = STIFFNESS * (q_targets - q) - DAMPING * dq
    data.ctrl[actuator_id] = torque

    mujoco.mj_step(model, data)

    base_heights.append(data.qpos[2])
    quat_now = data.qpos[3:7]
    w, x, y, z = quat_now
    roll = np.arctan2(2*(w*x+y*z), 1-2*(x*x+y*y))
    pitch = np.arcsin(np.clip(2*(w*y-z*x), -1, 1))
    rp_list.append((np.degrees(roll), np.degrees(pitch)))
    if step % frame_stride == 0:
        renderer.update_scene(data, camera=cam)
        frames.append(renderer.render().copy())

base_heights = np.array(base_heights)
rp_arr = np.array(rp_list)
print("min height:", base_heights.min(), "max height:", base_heights.max(), "final height:", base_heights[-1])
print("any nan:", np.isnan(data.qpos).any())
print("final base xy:", data.qpos[0], data.qpos[1])
print("roll range:", rp_arr[:,0].min(), rp_arr[:,0].max())
print("pitch range:", rp_arr[:,1].min(), rp_arr[:,1].max())

imageio.mimsave("go2_run.mp4", frames, fps=30)
print("saved video: go2_run.mp4, frames:", len(frames))
その方策、実機に載せる前に確かめませんか。
学習した歩行方策や制御ロジックを、実機投入前にもう一段検証したい。そんな段階からご相談いただけます。
シミュレーション間の突き合わせで見えてくる問題は、想定されているより多いと考えます。